アメリカ駐在員の簡単レシピ集
子供に九九を練習させたい
小学校2年生になると、かけ算九九を頑張って覚えますよね。
最近は、単語カードみたいなのが学校で配られて、頑張って覚えるようです。
ただ、カードだと、苦手な段とか、感覚でしかわからないですよね。
そこで、Android & Kindleアプリを作ってみました。
小学校の先生は算数の教材として、保護者は子どもの勉強や九九の練習アプリとしてご活用ください。
九九アプリ
Chromebook、Androidスマホとタブレット、KindleFireで、完全無料で利用できる九九の練習アプリです。
れんしゅうモード、ランダムモード、とっくんモード、スコア表があります。
各アプリストアは、こちら↓
- 「れんしゅうモード」:1の段~9の段を練習します。
- 「ランダムモード」:ランダムな10問が出ます。
- 「とっくんモード」:まちがった問題が自動で出てきて特訓できます。
- 「スコア」:それぞれモードのベストスコアを確認できます。
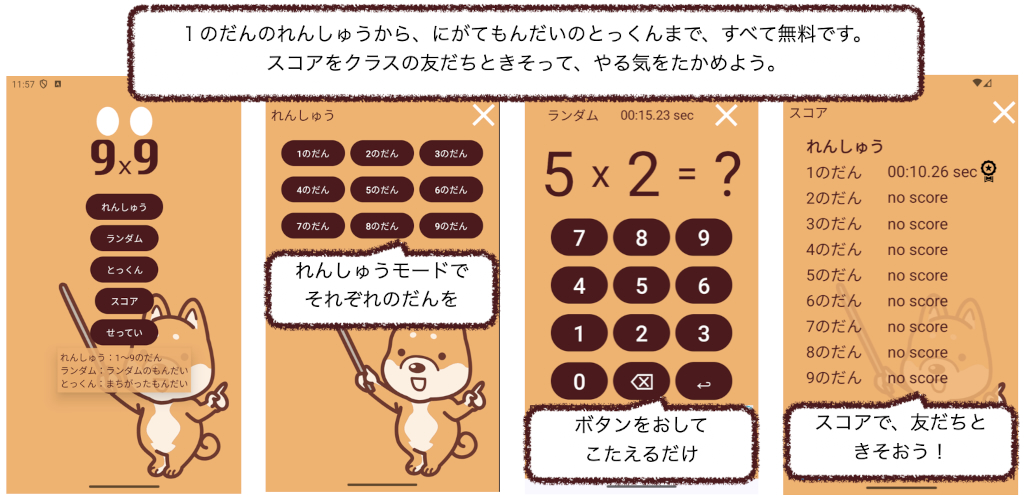
小学2年生で習う九九を、このアプリを使って練習できます。
小学校の先生が、以下の教材として、授業で利用することを想定しています。
- 九九指導後の練習
- ちょっとした算数の空き時間の自習
- クラスの仲間で、ベストスコアのタイムや、取得したメダルの競争
- 九九を覚えるための宿題
広告が表示されますが、全て無料で利用できます。
なお、子供に不適切だと思われる広告は除いてあります。
- 参考リンク
どうやったら子供が本を読むようになるか?
「本を読むと、賢くなる」よく聞く話ですが、本当でしょうか。「本を読む子が、賢い」では?とか思ったりします。しかし、親としては、子供に本を読んでほしい気持ちはどこかにあると思います。かくゆう私もその一人です。
うちの場合は、毎週の様に市民センターに併設されている小さめの図書館に通い(主に妻が)、毎週1人10冊位借りて読んでいます。小さい頃から絵本をこのペースで読み聞かせしていたら(主に妻が)、小学生低学年の頃には、いつの間にか、自分で読みたい本を読む様になっていました。今では私より子供の方が、よく本を読んでいます。
2つのハードル
私の経験から、子供に本を読む習慣をつけるのは、次の2つの大きなハードルがあると考えます。
- 幼少期
- 絵本を読み聞かせることができるか
- 小学校低〜中学年
- 絵本から読み物へ進化できるか
幼少期:絵本を読み聞かせることができるか
まず、親がせっせと、幼少期に絵本を読み聞かせることです。娯楽を求める子供にとって、絵本が楽しみになります。ここでは、いかに親が頑張って続けられるかがキーになってくる様に思います。
近くに日本の図書館がない場合、フリーの絵本もあったりします。また、海外の場合、日本人のコミニティのFacebookとかがあったりすると、そこで絵本をやり取りしてたりします。その様な場所を活用しましょう。
小学校低〜中学年:絵本から読み物へ進化できるか
個人的にはこのハードルが最も難関です。逆に言うと、このハードルを越えれば、あとは勝手に子供が進んで本を読む様になります。しかし、はじめは、今まで絵がたくさんあった本なのに、文字だけになります。子供も「うわ、こんなの読めない」と思うはずです。
私は次のことをして、このハードルを超えるように働きかけました。
- 絵本、マンガ、イラスト多めの本を自分で読ませる
- テレビアニメの原作を勧める
- 「どうわがいっぱい」背表紙の本を勧める
- 子供の好きな絵本の作家や、好きなイラストの本を勧める
絵本、マンガ、イラスト多めの本を自分で読ませる
まず、大人に読んでもらうのではなく、マンガでもいいから自分で読む習慣をつけることが大切です。そのために、絵本やマンガを使いましょう。マンガはダメという考えは捨てましょう。大人になっても漫画を読んでる人、いっぱいいますよ。小説だって、昔はサブカルチャーだったんです。あと、日本の漫画は世界に誇れる立派な文化です。全然問題ありません。
また、イラストがふんだんで読みやすい本、たくさんあります。
テレビアニメの原作を勧める
子供は流行りに敏感です。流行りのテレビアニメも活用しましょう。ワンピース、ナルト、名探偵コナン、ちびまる子ちゃん、SPY×FAMILYとか、マンガが原作ですよね。図書館で借りましょう。全部というわけではありませんが、少年誌のマンガだと、話の内容も小学生向けて安心ですよね。(少年誌=少年ジャンプ、少年マガジン、少年サンデー、コロコロ、など)
また、少年誌だと何が良いって、漢字にフリガナがふってあるんです。青年誌(ヤングジャンプ、ヤングマガジン、など)だと、フリガナがないから、子供にとってストレスなんですよね。
「どうわがいっぱい」背表紙の本を勧める
実は講談社の本の背表紙に、こんなマークがついていることがあります。これは文字が大きくて、読み物をはじめる子にぴったりのマークです。おばけずかんシリーズはこのマークがついています。ぜひ、探してみてください。
子供の好きな絵本の作家や、好きなイラストの本を勧める
子供が興味があることを、本に繋げましょう。イラスト、話の内容(冒険、虫、恐竜、料理、お菓子、武士)など、自分の子供が好きな物、ご存知ですよね?その内容の本を探して勧めてみてはどうでしょう。
子供の好きな領域の幅を広めるには、好きな分野のちょっと外を勧めるのがいいと思います。例えば、女の子でお菓子作りが好きなら、ルルとララシリーズの、ケーキとか、クッキーとかを作る本とか。科学系が好きな子なら、サバイバルシリーズや、Dr .STONEとか。武士や忍者が好きなら、角川の歴史まんがとか。例えば、こっそり借りてきて、本棚に置いておくだけでいいんです。子供が暇な時に、手を伸ばして読んだらこっちのものです。ダメもとでやてみてください。
以上
フリー小説をKindleの縦書きファイルへ変換する(3)※青空文庫
- はじめに
- 1話ごとのテキストを、一括でダウンロード
- Powershellで、1つのファイル(EPUB)を生成(小説家になろう 版)
- Kindle PreviewerでMOBIファイルへ変換し、USB接続でKindleへ転送
Powershellで、1つのファイル(EPUB)を生成
以下のPowerShellを使えば、実行するだけで、epubファイルが生成されます。
青空文庫のHTMLは、ダウンロードしたHTMLは、目次が外れてしまうのと、縦書きにならないのが難点です。
このPowerShellは、目次と縦書きを実現します。
例えば、15少年漂流記(ちょっとなまえちがうけど)を例に変換してみましょう。
www.aozora.gr.jp

実行する際のファイル構成
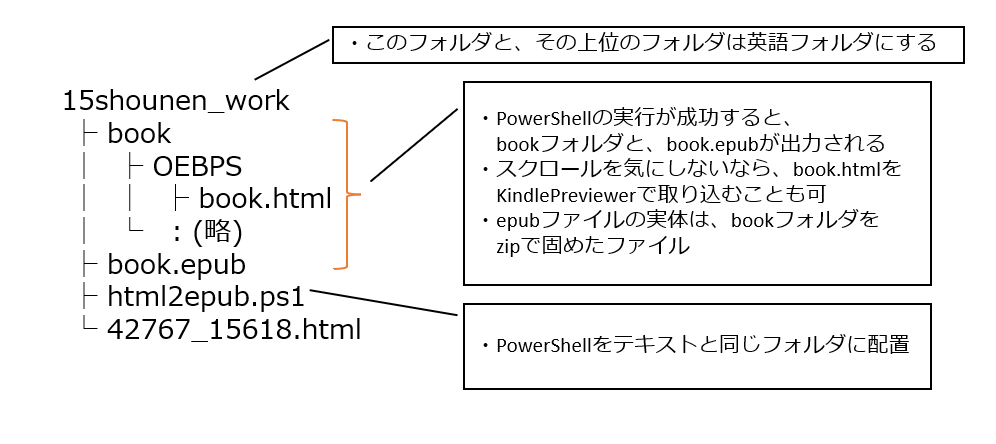
実行する際の注意点
- 検証済環境:Windows10、PowerShell Ver. 5.1.19041.2364
- html2epub.ps1の文字コード=Shift-JIS
- 作業フォルダは英数字のフォルダで作業してください
- あたり前ですが、ZIPファイルは解凍してください。ZIPファイルのままでは、powershellは実行できません。
html2epub.ps1
下記のテキストをテキストエディタにコピー&ペーストして
「html2epub.ps1」と言うファイル名で保存します。
###########################################################
# Title: 青空文庫のHTMLに目次を追加してepubファイルにする
# Created:2023/03/15
# Usage:
# > Powershell 実行方法
# > PowerShell -ExecutionPolicy RemoteSigned -file .\html2epub.ps1 "title" xxx.html
# File Tree:
# book.epub = zip
# ├ META-INF
# │ └ container.xml
# ├ OEBPS
# │ ├ book.html
# │ ├ content.opf
# │ └ toc.ncx
# └ mimetype
###########################################################
$outFile = 'book\OEBPS\book.html' # 結合後のファイル名
if([string]::IsNullorEmpty($Args[0])){
Write-Host "Usage: PowerShell -ExecutionPolicy RemoteSigned -file .\html2epub.ps1 `"title`""
Write-Host ""
exit
}
$htmlTitle = $Args[0]
Write-Host "Titile :" $htmlTitle
$uuid = "html2epub-" + ( Get-Date -Format "yyyyMMdd-HHmmss" )
$htmlStyle = "<style type=`"text/css`">
<!--
body, h1, p {
writing-mode: vertical-rl;
text-orientation: upright;
-webkit-writing-mode:vertical-rl;
-epub-writing-mode:vertical-rl;
-moz-writing-mode:vertical-rl;
-o-writing-mode:vertical-rl;
}
-->
</style>"
$opfBody = "<?xml version=`"1.0`" encoding=`"utf-8`"?>
<package version=`"2.0`" unique-identifier=`"BookId`" xmlns=`"http://www.idpf.org/2007/opf`">
<metadata xmlns:dc=`"http://purl.org/dc/elements/1.1/`" xmlns:opf=`"http://www.idpf.org/2007/opf`">
<meta content=`"horizontal-rl`" name=`"primary-writing-mode`"/>
<dc:identifier id=`"BookId`" opf:scheme=`"UUID`">urn:uuid:" + $uuid + "</dc:identifier>
<dc:language>ja</dc:language>
<dc:title>" + $htmlTitle + "</dc:title>
<dc:date opf:event=`"modification`" xmlns:opf=`"http://www.idpf.org/2007/opf`">" + ( Get-Date -UFormat "%Y-%m-%d" ) + "</dc:date>
</metadata>
<manifest>
<item id=`"book.html`" href=`"book.html`" media-type=`"application/xhtml+xml`"/>
<item id=`"ncx`" href=`"toc.ncx`" media-type=`"application/x-dtbncx+xml`"/>
</manifest>
<spine toc=`"ncx`">
<itemref idref=`"book.html`"/>
</spine>
</package>"
$containerBody = "<?xml version=`"1.0`" encoding=`"UTF-8`"?>
<container version=`"1.0`" xmlns=`"urn:oasis:names:tc:opendocument:xmlns:container`">
<rootfiles>
<rootfile full-path=`"OEBPS/content.opf`" media-type=`"application/oebps-package+xml`"/>
</rootfiles>
</container>"
$ncxBody = "<?xml version=`"1.0`" encoding=`"utf-8`"?>
<!DOCTYPE ncx PUBLIC `"-//NISO//DTD ncx 2005-1//EN`"
`"http://www.daisy.org/z3986/2005/ncx-2005-1.dtd`">
<ncx xmlns=`"http://www.daisy.org/z3986/2005/ncx/`" version=`"2005-1`">
<head>
<meta name=`"dtb:uid`" content=`"urn:uuid:" + $uuid + "`" />
<meta name=`"dtb:depth`" content=`"0`" />
<meta name=`"dtb:totalPageCount`" content=`"0`" />
<meta name=`"dtb:maxPageNumber`" content=`"0`" />
</head>
<docTitle>
<text>" + $htmlTitle + "</text>
</docTitle>
<navMap>
<navPoint id=`"navPoint-1`" playOrder=`"1`">
<navLabel>
<text>目次へ</text>
</navLabel>
<content src=`"book.html`" />
</navPoint>
</navMap>
</ncx>"
$mimetype = "application/epub+zip"
# ---------------------------------------------------------
# 結合後のファイルがあった場合は削除
Write-Host "Delete : book dir, book.epub, book.zip"
If(Test-Path "book"){
Remove-Item -Path "book" -Recurse
}
If(Test-Path "book.epub"){
Remove-Item -Path "book.epub"
}
If(Test-Path "book.zip"){
Remove-Item -Path "book.zip"
}
# フォルダ&ファイルの生成
New-Item "book" -ItemType Directory > $null
New-Item "book\META-INF" -ItemType Directory > $null
New-Item "book\OEBPS" -ItemType Directory > $null
Write-Output $containerBody | Out-File -FilePath "book\META-INF\container.xml" -Append -Encoding UTF8
Write-Output $mimetype | Out-File -FilePath "book\mimetype" -Append -Encoding UTF8
Write-Output $opfBody | Out-File -FilePath "book\OEBPS\content.opf" -Append -Encoding UTF8
Write-Output $ncxBody | Out-File -FilePath "book\OEBPS\toc.ncx" -Append -Encoding UTF8
# ---------------------------------------------------------
# 目次の生成
$orgHtml = $Args[1]
Write-Host "SrcHtml :" $orgHtml
$xmlDoc = [xml](Get-Content $orgHtml -Encoding Default)
# $xmlNav = [Xml.Xpath.XPathNavigator]$xmlDoc.CreateNavigator()
$val = 0 # カウンター
$agenda = $xmlDoc.html.body.div.div|
foreach {
if( $null -ne $_ ){
if( $_['h3'] -ne $null){
" <a href=`"#" + $_['h3'].a.id + "`">" + $_['h3'].a.InnerXML + "</a><br />`n"
}
if( $_['h4'] -ne $null){
" <a href=`"#" + $_['h4'].a.id + "`">" + $_['h4'].a.InnerXML + "</a><br />`n"
}
$val = $val + 1
Write-Host -NoNewline ("`r" + "Progress: ${val}")
}
}
Write-Host ""
$agendaAll = "<h1 style=`"page-break-before:always`">目次</h1>`n" + $agenda
#Write-Host $agendaAll
#$Navi.Select("//h4")
#$Navi.Select("//h4") | select Name
# ---------------------------------------------------------
# 本文へ目次を挿入
[string]$srcStr = "<div class=`"main_text`"><br />"
[string]$destStr = $agendaAll + $srcStr
(Get-Content $orgHtml -Encoding Default) | foreach { $_ -replace $srcStr,$destStr } | Set-Content $outFile -Encoding Default
# CSSを挿入
[string]$srcCssStr = "</head>"
[string]$desCsstStr = $htmlStyle + $srcStr
(Get-Content $outFile -Encoding Default) | foreach { $_ -replace $srcCssStr,$desCsstStr } | Set-Content $outFile -Encoding Default
# ---------------------------------------------------------
# ZIP圧縮 & 拡張子変更
Compress-Archive -Path "book" -DestinationPath "book.zip"
Rename-Item -Path "book.zip" -NewName "book.epub"
Write-Host "Created : book.epub"
実行例
PowerShell -ExecutionPolicy RemoteSigned -file .\html2epub.ps1 "無人島に生きる十六人" .\42767_15618.html
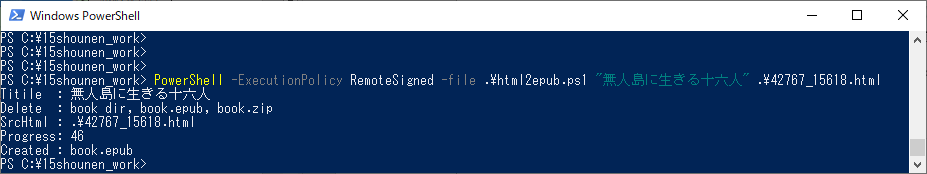
- book.epubファイルができていたら成功です。
以上
フリー小説をKindleの縦書きファイルへ変換する(4)
- はじめに
- 1話ごとのテキストを、一括でダウンロード
- Powershellで、1つのファイル(EPUB)を生成(小説家になろう版)
- Kindle PreviewerでMOBIファイルへ変換し、USB接続でKindleへ転送
Kindle PreviewerでMOBIファイルへ変換し、USB接続してKindleへ転送
amazonのフリーツール「Kindle Previewer」を使えば.mobiファイルへエクスポートが可能です。今回は、Kindle Previewer Ver.3.7.1.0を使いました。
手順
- 「Kindle Previewer」からダウンロードし、ウィザードに従ってインストールします。
- Kindle Previewerを起動し、.epubファイルをドラッグ&ドロップで開きます。
- この後、ファイルの読み込みと変換に数分時間がかかります。
- テキストファイルの数は、約300個ファイルが上限のようです。それ以上だとエラーになり途中で止まってしまいました。
-
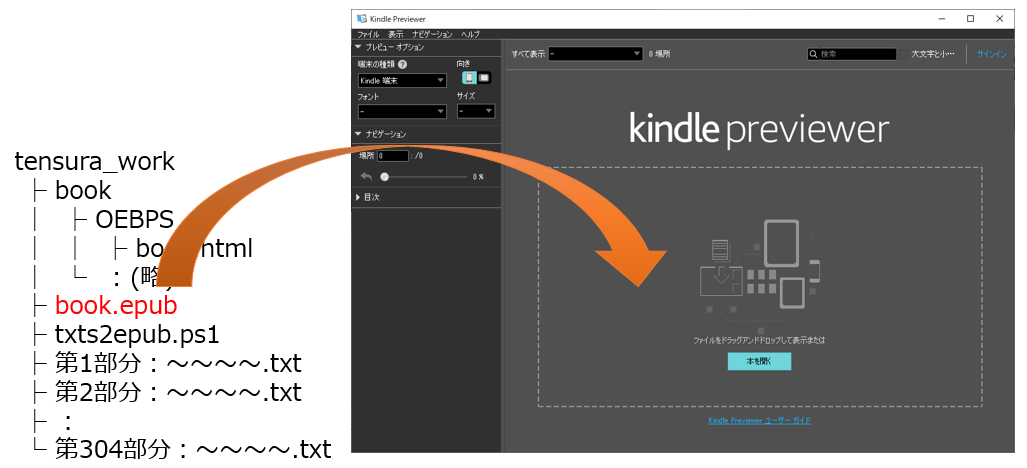
KindlePreviewerへD&D
- エクスポートします。
-
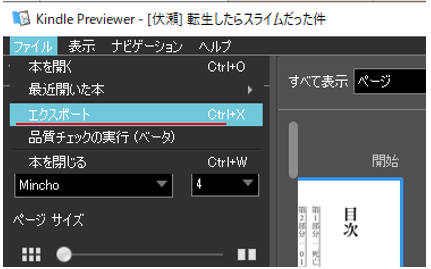
エクスポート - エクスポートするファイルの拡張子は「.mobi」を選びました。
- ファイル名は、本のタイトルなど、分かりやすい名前にした方がいいかと思います。
-
- USBケーブルでKindle端末とPCをつないでファイルを転送
- PCから接続を外し、Kindle端末のマイライブラリから、作成した本を開きます。
- 無事開けました。
-
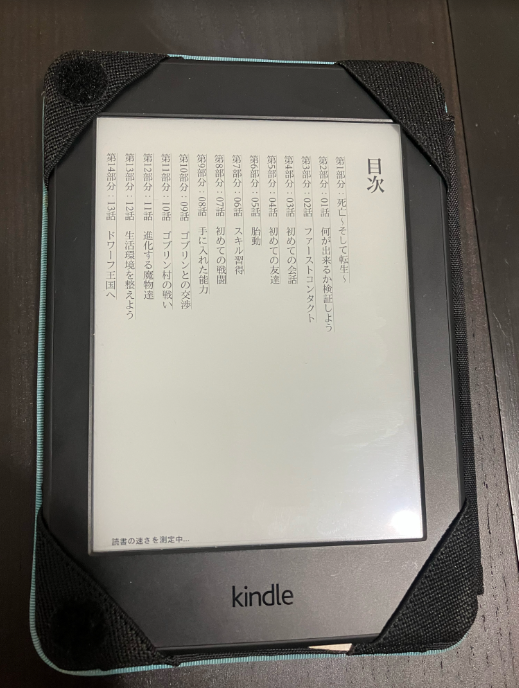
Kindleで開いた様子、1ページ目は目次 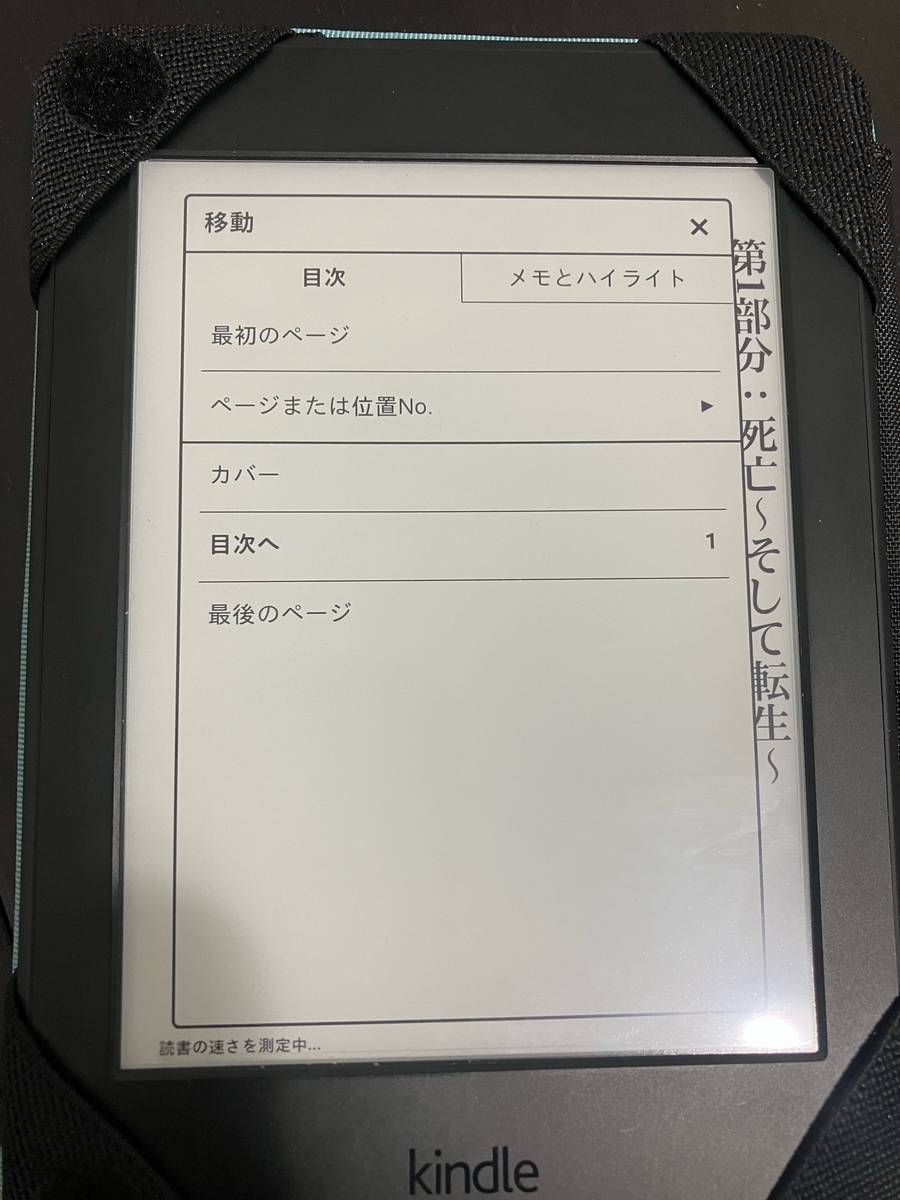
目次には「目次へ」から1ページ目へジャンプできます。 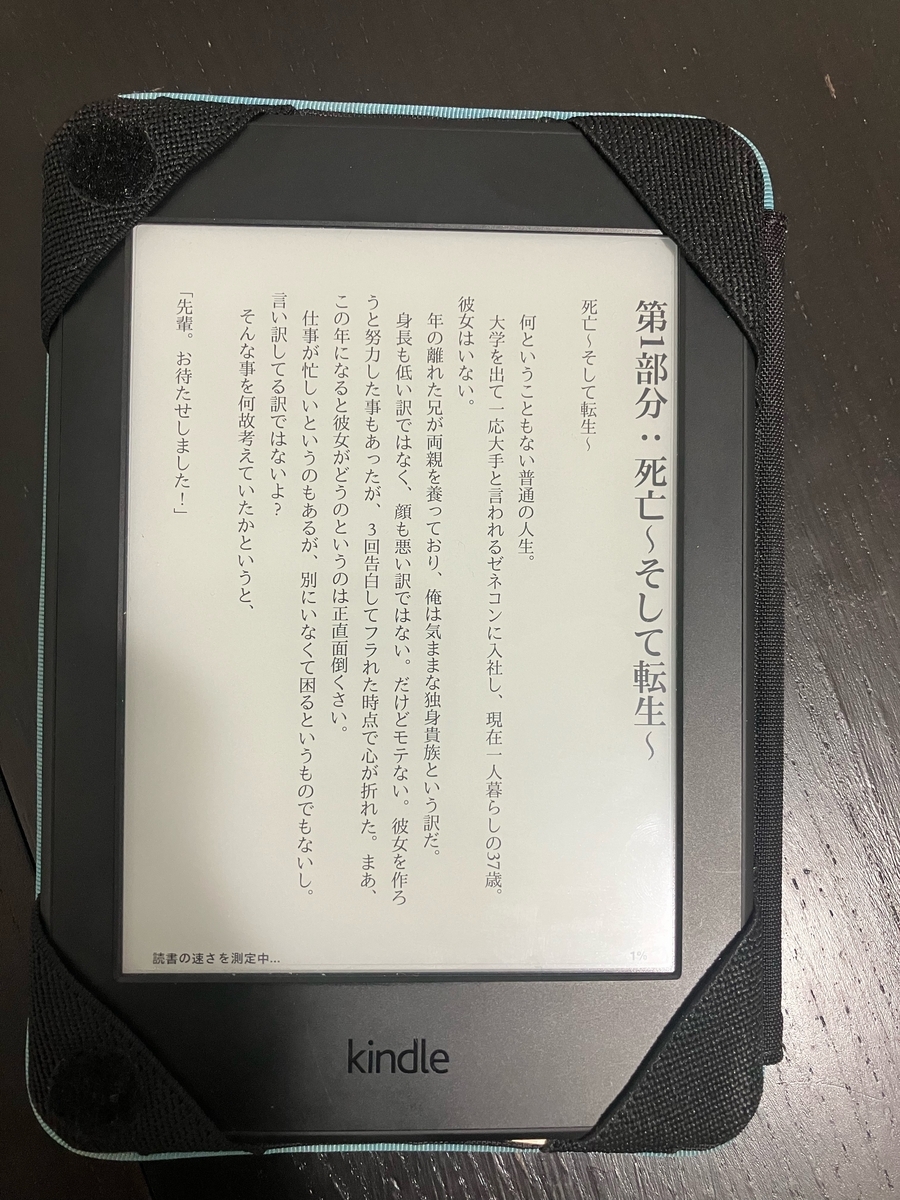
1話目の様子
以上
フリー小説をKindleの縦書きファイルへ変換する(3)※小説家になろう版
- はじめに
- 1話ごとのテキストを、一括でダウンロード
- Powershellで、1つのファイル(EPUB)を生成
- Kindle PreviewerでMOBIファイルへ変換し、USB接続でKindleへ転送
Powershellで、1つのファイル(EPUB)を生成
以下のPowerShellを使えば、実行するだけで、epubファイルが生成されます。
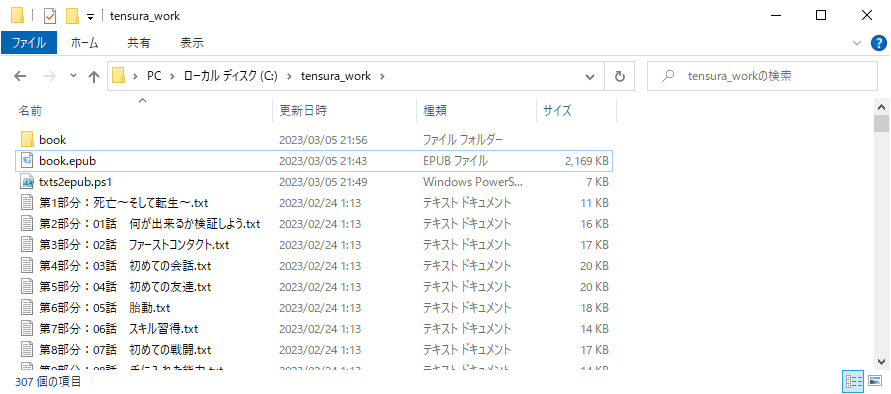
実行する際のファイル構成
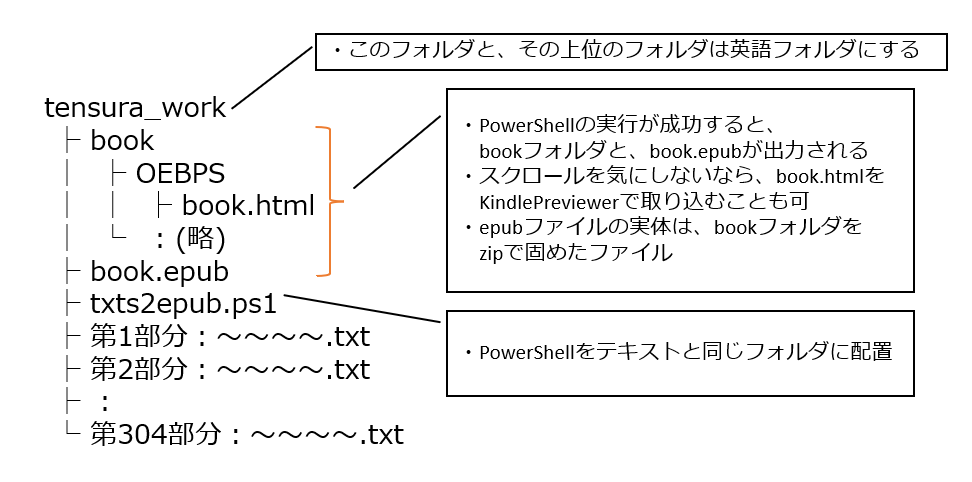
実行する際の注意点
- 検証済環境:Windows10、PowerShell Ver. 5.1.19041.2364
- txts2epub.ps1の文字コード=Shift-JIS
- 作業フォルダは英数字のフォルダで作業してください
- あたり前ですが、ZIPファイルは解凍してください。ZIPファイルのままでは、powershellは実行できません。
txts2epub.ps1
下記のテキストをテキストエディタにコピー&ペーストして
「txts2epub.ps1」と言うファイル名で保存します。
###########################################################
# Title:  小説になろうのテキスト群をを、結合してepubファイルにする
# Created:2023/02/28
# Updated:2025/05/08 なろうのDLテキストファイル名の仕様変更に対応

# Usage:
# > Powershell 実行方法
# > PowerShell -ExecutionPolicy RemoteSigned -file .\txts2epub.ps1 "title"

# File Tree:
#  book.epub = zip
#   ├ META-INF
#   │  └ container.xml
#   ├ OEBPS
#   │  ├ book.html
#   │  ├ content.opf
#   │  └ toc.ncx
#   └ mimetype
###########################################################
$fileList  = Get-ChildItem -Name "*.txt" | Sort-Object LastWriteTime
$outFile   = 'book\OEBPS\book.html'  # 結合後のファイル名
$hr_string = '********************************************'  # 初めにコメントがある場合の区切り文字

# 見出しを取得する
function getEachSubject( $file ) {
	$midashi_array = Get-Content $file -TotalCount 15 -Encoding UTF8
  if ($midashi_array.Contains($hr_string)) {
    # 区切り文字がある場合は、その次の行を取得する
    for($i=0; $i -lt $midashi_array.Length; $i++){
      if($midashi_array[$i] -eq $hr_string){
        # Write-Output $midashi_array[$i + 1]
        $midashi = $midashi_array[$i + 1]
        break
      }
    }
  } else {
    # 1行目を取得
    $midashi = Get-Content $fileNameHashTable[($key)] -Encoding UTF8 | Select-Object -First 1
  }
  return $midashi
}


if([string]::IsNullorEmpty($Args[0])){
  Write-Host "Usage: PowerShell -ExecutionPolicy RemoteSigned -file .\txts2epub.ps1 `"title`""
  Write-Host ""
  exit
}
$htmlTitle = $Args[0]
Write-Host "Titile  :" $htmlTitle
$uuid = "txts2epub-" + ( Get-Date -Format "yyyyMMdd-HHmmss" )
$htmlHeader = "<html>
<head>
<title>" + $htmlTitle + "</title>
<meta http-equiv=`"Content-Type`" content=`"text/html; charset=utf-8`" />
<style type=`"text/css`">
    <!--
        body, h1, p {
            writing-mode: vertical-rl;
            text-orientation: upright;
            -webkit-writing-mode:vertical-rl;
            -epub-writing-mode:vertical-rl;
            -moz-writing-mode:vertical-rl;
            -o-writing-mode:vertical-rl;
        }
    -->
</style>
</head>
<body>"
$htmlFooter = "</body>
</html>"

$opfBody = "<?xml version=`"1.0`" encoding=`"utf-8`"?>
<package version=`"2.0`" unique-identifier=`"BookId`" xmlns=`"http://www.idpf.org/2007/opf`">
  <metadata xmlns:dc=`"http://purl.org/dc/elements/1.1/`" xmlns:opf=`"http://www.idpf.org/2007/opf`">
    <meta content=`"horizontal-rl`" name=`"primary-writing-mode`"/>
    <dc:identifier id=`"BookId`" opf:scheme=`"UUID`">urn:uuid:" + $uuid + "</dc:identifier>
    <dc:language>ja</dc:language>
    <dc:title>" + $htmlTitle + "</dc:title>
    <dc:date opf:event=`"modification`" xmlns:opf=`"http://www.idpf.org/2007/opf`">" + ( Get-Date -UFormat "%Y-%m-%d" ) + "</dc:date>
  </metadata>
  <manifest>
    <item id=`"book.html`" href=`"book.html`" media-type=`"application/xhtml+xml`"/>
    <item id=`"ncx`" href=`"toc.ncx`" media-type=`"application/x-dtbncx+xml`"/>
  </manifest>
  <spine toc=`"ncx`">
    <itemref idref=`"book.html`"/>
  </spine>
</package>"

$containerBody = "<?xml version=`"1.0`" encoding=`"UTF-8`"?>
<container version=`"1.0`" xmlns=`"urn:oasis:names:tc:opendocument:xmlns:container`">
    <rootfiles>
        <rootfile full-path=`"OEBPS/content.opf`" media-type=`"application/oebps-package+xml`"/>
   </rootfiles>
</container>"

$ncxBody = "<?xml version=`"1.0`" encoding=`"utf-8`"?>
<!DOCTYPE ncx PUBLIC `"-//NISO//DTD ncx 2005-1//EN`"
   `"http://www.daisy.org/z3986/2005/ncx-2005-1.dtd`">
<ncx xmlns=`"http://www.daisy.org/z3986/2005/ncx/`" version=`"2005-1`">
  <head>
    <meta name=`"dtb:uid`" content=`"urn:uuid:" + $uuid + "`" />
    <meta name=`"dtb:depth`" content=`"0`" />
    <meta name=`"dtb:totalPageCount`" content=`"0`" />
    <meta name=`"dtb:maxPageNumber`" content=`"0`" />
  </head>
<docTitle>
  <text>" + $htmlTitle + "</text>
</docTitle>
<navMap>
<navPoint id=`"navPoint-1`" playOrder=`"1`">
  <navLabel>
    <text>目次へ</text>
  </navLabel>
  <content src=`"book.html`" />
</navPoint>
</navMap>
</ncx>"

$mimetype = "application/epub+zip"

# ---------------------------------------------------------
# 結合後のファイルがあった場合は削除
Write-Host "Delete  : book dir, book.epub, book.zip"

If(Test-Path "book"){
  Remove-Item -Path "book" -Recurse
}
If(Test-Path "book.epub"){
  Remove-Item -Path "book.epub"
}
If(Test-Path "book.zip"){
  Remove-Item -Path "book.zip"
}

# フォルダ&ファイルの生成
New-Item "book"          -ItemType Directory > $null
New-Item "book\META-INF" -ItemType Directory > $null
New-Item "book\OEBPS"    -ItemType Directory > $null
Write-Output $containerBody | Out-File -FilePath "book\META-INF\container.xml"  -Append -Encoding UTF8
Write-Output $mimetype      | Out-File -FilePath "book\mimetype"                -Append -Encoding UTF8
Write-Output $opfBody       | Out-File -FilePath "book\OEBPS\content.opf"       -Append -Encoding UTF8
Write-Output $ncxBody       | Out-File -FilePath "book\OEBPS\toc.ncx"           -Append -Encoding UTF8

# ---------------------------------------------------------
$cnt = 0  # カウンター

# define hash table
$fileNameHashTable = @{};
$fileIndexHashTable = @{};

# ファイル名と、ソートするキーの取得
foreach($f in $fileList){
  # set index
  # ファイル名が「第NNN部分~.txt」となるので、1文字目を飛ばして、部分で分割(split)して数字を取得
  # 2025/05/08 なろうの仕様変更により、8行目以降の数字を取得
  $fileIndexHashTable.Add($cnt , [int]$f.Substring(8).Split('.txt')[0]);
  # set file name
  $fileNameHashTable.Add($cnt , $f);
  $cnt++
}

# indexでソート
$fileIndexHashTable = $fileIndexHashTable.GetEnumerator() | sort -Property value

# ヘッダの出力
Write-Output $htmlHeader | Out-File -FilePath $outFile -Append -Encoding UTF8

# 目次の生成
Write-Output ( "<h1>目次</h1>`r`n<p>" )  | Out-File -FilePath $outFile -Append -Encoding UTF8
foreach($fileEnt in $fileIndexHashTable){
  $key = $fileEnt.Key;
  $val = $fileEnt.Value;
  # ファイル名を目次にする
  # $midashi = [System.IO.Path]::GetFileNameWithoutExtension($fileNameHashTable[($key)])
  # 2025/05/08 なろうの仕様変更により、ファイルの1行目を目次にする
  $midashi = getEachSubject($fileNameHashTable[($key)])
  Write-Output ( "<a href=`"#" + $val + "`">" + $val + "  " + $midashi + "</a><br />" )  | Out-File -FilePath $outFile -Append -Encoding UTF8
}
Write-Output ( "`r`n</p>`r`n" )  | Out-File -FilePath $outFile -Append -Encoding UTF8

# 本文の生成
foreach($fileEnt in $fileIndexHashTable){
  $key = $fileEnt.Key;
  $val = $fileEnt.Value;
  # Write-Host ( $fileNameHashTable[($key)] )
  # PROGRESS
  Write-Host -NoNewline ("`r" + "Progress: ${val} / ${cnt} ")

  # 2025/05/08 なろうの仕様変更により、ファイルの1行目を目次にする
  # $midashi = [System.IO.Path]::GetFileNameWithoutExtension($fileNameHashTable[($key)])
  $midashi = getEachSubject($fileNameHashTable[($key)])
  Write-Output ( "<h1 id=`"" + $val + "`" style=`"page-break-before:always`">" + $val + "  " + $midashi + "</h1>`r`n<p>" ) | Out-File -FilePath $outFile -Append -Encoding UTF8

  #$htmlBody = Get-Content  -Encoding UTF8
  # Get-Content $htmlBody -Encoding UTF8   | Out-File -FilePath $outFile -Append -Encoding UTF8

  $htmlBody = [System.IO.File]::ReadAllText($fileNameHashTable[($key)]).Replace("`r`n","<br />`r`n")
  ($htmlBody + "`r`n</p>`r`n" )| Out-File -FilePath $outFile -Append -Encoding UTF8
}

# フッタの出力
Write-Output $htmlFooter | Out-File -FilePath $outFile -Append -Encoding UTF8
Write-Host ""

# ---------------------------------------------------------
# ZIP圧縮 & 拡張子変更
Compress-Archive -Path "book" -DestinationPath "book.zip"
Rename-Item -Path "book.zip" -NewName "book.epub"
Write-Host "Created : book.epub"
実行方法
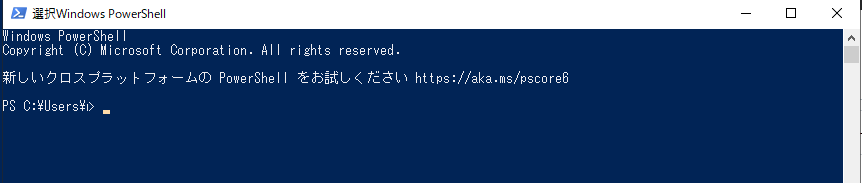
- スタートメニュー等からPowerShellを起動
- txts2epub.ps1を実行
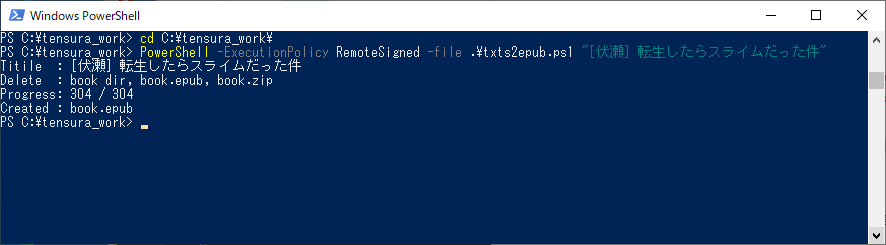
cdコマンドで、カレントフォルダを小説のテキストとpowershellを置いたPATHへ移動してから、実行してください。
PS C:\> cd C:\tensura_work\
PS C:\tensura_work> PowerShell -ExecutionPolicy RemoteSigned -file .\txts2epub.ps1 "[伏瀬] 転生したらスライムだった件"
Titile  : [伏瀬] 転生したらスライムだった件
Delete  : book dir, book.epub, book.zip
Progress: 304 / 304
Created : book.epub
- book.epubファイルができていたら成功です。
以上
フリー小説をKindleの縦書きファイルへ変換する(2)
- はじめに
- 1話ごとのテキストを、一括でダウンロード
- Powershellで、1つのファイル(EPUB)を生成(小説家になろう版)
- Kindle PreviewerでMOBIファイルへ変換し、USB接続でKindleへ転送
1話ごとのテキストを、一括でダウンロード
「小説家になろう」の場合
<訂正>
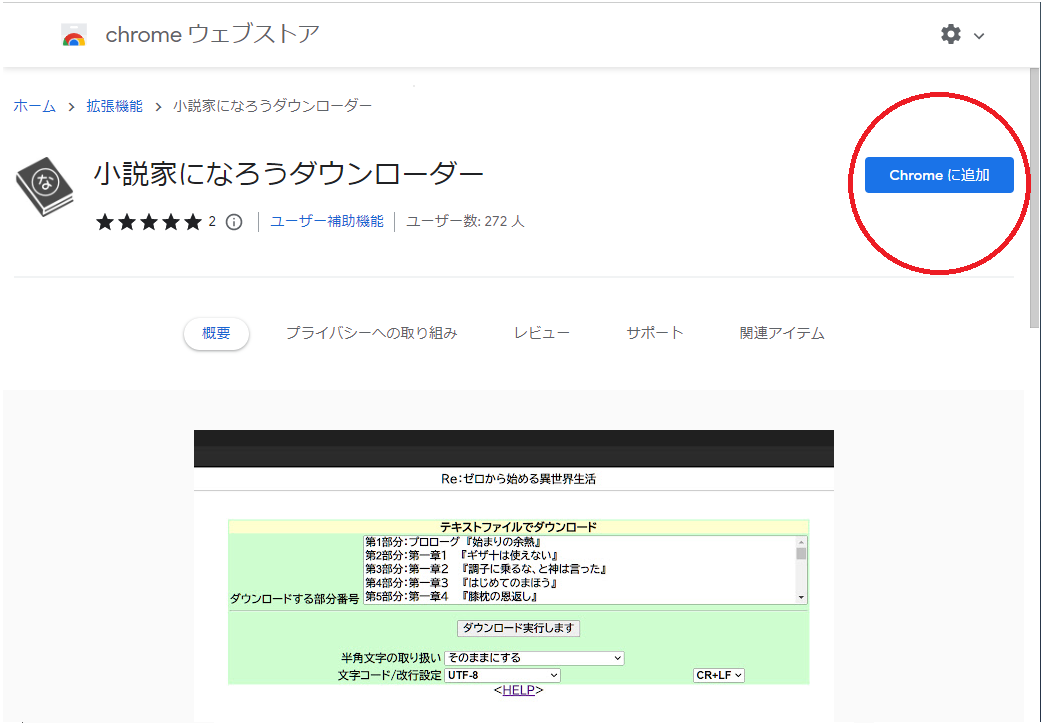
2025年5月時点で、以下のクロームのプラグインは削除されているようです。
代わりに以下のバッチファイルでダウンロードができそうです。
一括でダウンロードするために、chromeのプラグインをインストールします。
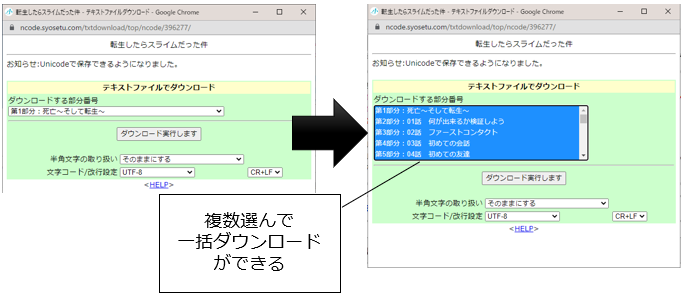
- 拡張機能のインストール
- 一括ダウンロード
- 「小説家になろう」で、TXTダウンロードをするためには、ユーザ登録が必要です。事前に登録してください。
- 例えば「転生したらスライムだった件」なら、この一覧のページに行きます。ページの下の方に「TXTダウンロード」のリンクがあります。
-
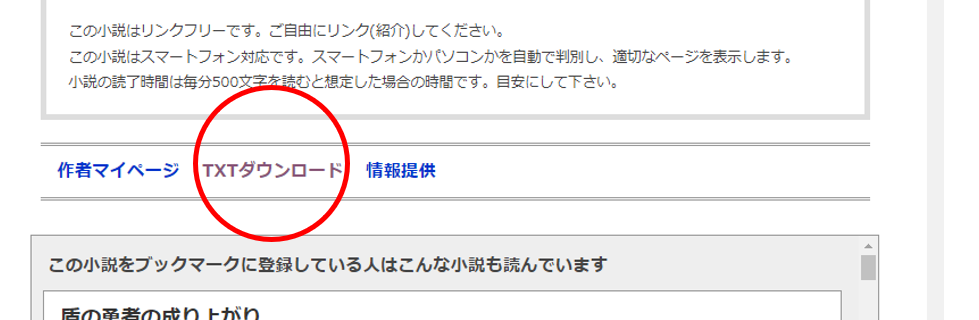
TXTダウンロードのリンク -
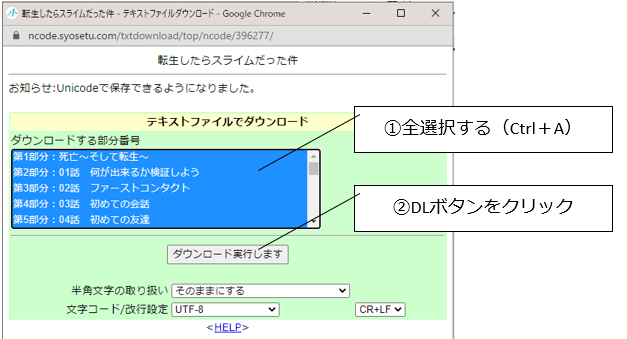
小説家になろう一括ダウンロード
- ZIPファイルになってダウンロードされる
-
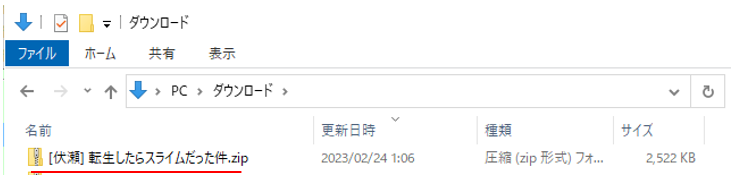
ダウンロードしたZIPファイル
-
以上
